Einen Knowledge Graph erstellen heißt, Wissen als Netz aus Knoten und benannten Beziehungen abzulegen, nicht als Liste. Knoten sind die Dinge, um die es geht, bei Kundengesprächen also Calls, Fragen, Einwände, Antworten, Zielgruppen und Verwendungen. Beziehungen sind die Verben dazwischen: Ein Call enthält einen Einwand, eine Antwort beantwortet ihn, eine FAQ nutzt die Antwort. Eigenschaften wie Datum, Häufigkeit, Prüfer und Fundstelle hängen an beidem. Der Bau läuft in fünf Schritten: die Fragen aufschreiben, die der Graph beantworten soll; die Substantive daraus zu Knotentypen machen; die Verben zu Beziehungstypen; Eigenschaften festlegen; mit einer Handvoll Testdaten prüfen, ob jede Frage beantwortbar ist. Der Graph lohnt sich dort, wo eine Tabelle umständlich wird: Welcher Einwand taucht in welcher Zielgruppe auf, welche geprüfte Antwort gehört dazu, und in welchen FAQ- oder Vertriebsbausteinen wird sie bereits verwendet?
Mein Ausgangspunkt ist kein ungeprüfter Stapel Transkripte, sondern ein gepflegtes Register. Wie Fragen, Einwände und die bislang klarsten eigenen Antworten aus Calls entstehen, erklärt der Beitrag zum Muster-Register aus Gesprächsanalysen. Hier geht es um den nächsten Schritt: aus den Einträgen ein Netz mit benannten Beziehungen zu bauen. Welche Rolle bei mir welche Aufgabe übernimmt, sammle ich unter KI-Mitarbeiter.
Was ein Knowledge Graph anders macht
Eine Tabelle hält Zeilen und Spalten fest. Eine Wissensdatenbank macht Inhalte auffindbar. Ein Knowledge Graph stellt zusätzlich die Beziehungen zwischen den Dingen in den Mittelpunkt. Siemens beschreibt den Unterschied so: In einer relationalen Datenbank sind Beziehungen zwischen Entitäten implizit, in einem Wissensgraph sind sie explizit definiert. Im Graph ist die Verbindung selbst ein Datensatz mit Richtung, Typ und Eigenschaften, keine Verweisnummer in einer Spalte.
Neo4j beschreibt ein Property-Graph-Modell mit drei Grundbausteinen:
Knoten stehen für Dinge wie Call, Frage, Einwand, Antwort oder FAQ. Ein Knoten trägt ein oder mehrere Labels, die ihn einer Gruppe zuordnen, etwa Call oder Muster.
Beziehungen verbinden zwei Knoten und tragen ein Verb, etwa „wurde gefragt in“, „beantwortet durch“ oder „wird verwendet in“. Nach Neo4j hat eine Beziehung immer einen Startknoten, einen Endknoten, genau einen Typ und eine Richtung.
Eigenschaften sind Schlüssel-Wert-Paare an Knoten und Beziehungen. Sie speichern Werte wie Datum, Häufigkeit, Prüfer, Gültigkeit oder Fundstelle.
Praktisch heißt das: Der Graph kann zeigen, in welchen Gesprächen ein Einwand fiel, welche Antwort danach keine Rückfrage auslöste, wann sie zuletzt geprüft wurde und welche Website-Absätze von ihr abhängen. Das sind Fragen entlang von Verbindungen, und Verbindungen speichert ein Graph nativ.
Knowledge Graph erstellen: fünf Schritte von der Frage zum Modell
Neo4j nennt in seiner Modellierungsanleitung als ersten Schritt nicht die Software, sondern die Anwendungsfälle, wörtlich: „What questions are you trying to answer?“ Die Substantive in diesen Fragen werden zu Knoten, die Verben zu Beziehungen:
Fragen aufschreiben. Drei bis fünf Fragen, die dir heute Arbeit machen: Welche häufigen Einwände haben noch keine geprüfte Antwort? Welche Inhalte hängen an einer Antwort, die ich gerade ändere? Welcher Einwand fällt bei welcher Zielgruppe?
Substantive markieren. Einwand, Antwort, Inhalt, Zielgruppe: Das sind deine Knotentypen. Call kommt dazu, weil jede Fundstelle in einem Call liegt.
Verben markieren. „hat eine Antwort“, „hängt an“, „fällt bei“. Daraus werden die Beziehungstypen, so eng benannt wie möglich. Neo4j rät ausdrücklich zu spezifischen Namen; „gehört zu“ ist fast immer zu weit.
Eigenschaften zuordnen. Was du filtern oder sortieren willst, wird Eigenschaft: Datum, Häufigkeit, Status, letzte Prüfung. Was du nur lesen willst, bleibt Text im Knoten.
Mit Testdaten prüfen. Fünf Calls, zehn Muster, drei Antworten reichen. Dann jede Frage aus Schritt 1 gegen das Modell stellen. Bleibt eine unbeantwortbar, fehlt ein Knoten, eine Beziehung oder eine Eigenschaft.
Das Modell ist damit fertig, bevor irgendein Werkzeug installiert ist. Die drei Fragen aus Schritt 1 musst du nicht allein finden: In den Calls meiner Community gehen wir solche Modelle gemeinsam durch.
Das kleinste sinnvolle Datenmodell
Für ein Call-Register reichen zunächst fünf Knotentypen:
Knotentyp
Beispiel
Wichtige Eigenschaften
Call
Demo-Call 04
Datum, Gesprächsart, Freigabestatus
Muster
„Keine Zeit für die Einrichtung“
Kategorie, Häufigkeit, letzte Prüfung
Antwort
„Wir starten mit einem klar begrenzten Prozess“
Version, Verantwortlicher, Status
Zielgruppe
kleiner Handwerksbetrieb
Branche, Größenklasse
Verwendung
FAQ, Einwandkarte, Playbook
Kanal, URL, Aktualisierungsdatum
Die Beziehungen bekommen Richtung, Typ und, wo es hilft, eigene Eigenschaften: Ein Call enthält ein Muster, an der Kante steht die Minute im Gespräch. Ein Muster betrifft eine Zielgruppe. Eine Antwort beantwortet ein Muster, an der Kante das Signal, etwa „keine Rückfrage“. Eine Verwendung nutzt eine Antwort, an der Kante das Datum. Und eine Antwort ersetzt eine ältere Antwort. Die letzte ist die, die Tabellen selten hergeben: Die Kette bleibt erhalten, und du siehst später, welche Verwendung noch an der alten Fassung hängt.
Ein kleiner, beschrifteter Demo-Graph erklärt mehr als tausend unbenannte Punkte. Alle Calls und Aussagen sind fiktiv. Grafik: HumanITy
Knowledge Graph Beispiel: vom Call zur verwendbaren Antwort
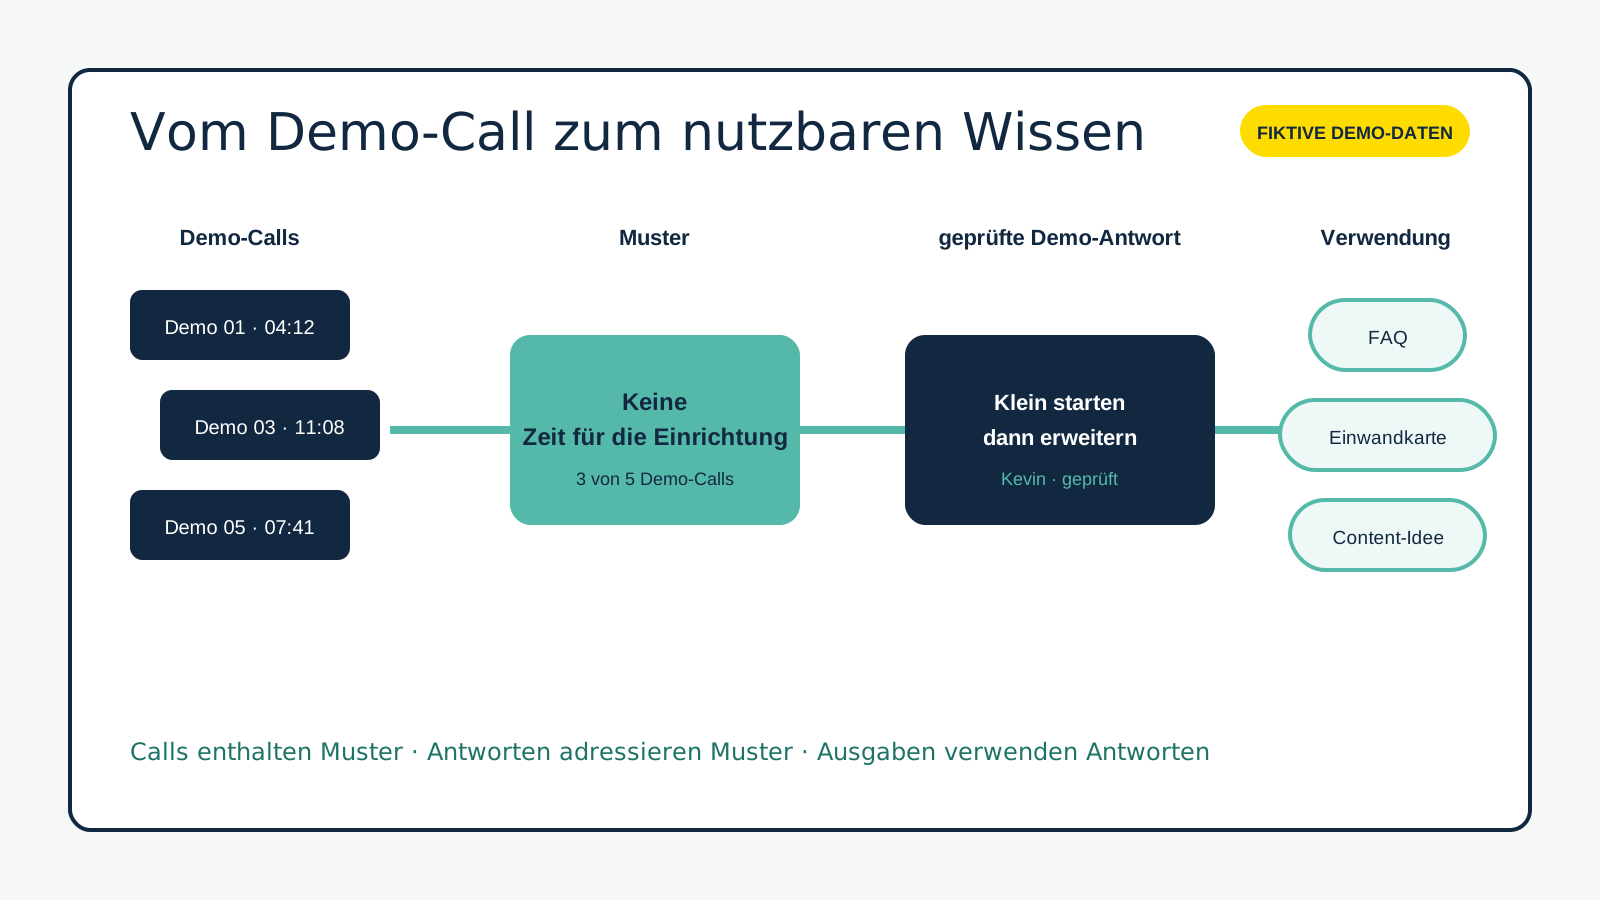
Das folgende Beispiel ist gebaut, mit ausdrücklich fiktiven Demo-Daten. Nehmen wir fünf Demo-Calls eines Handwerksbetriebs. In drei davon fällt der Einwand „Ich habe gerade keine Zeit für die Einrichtung“. Im Register steht außerdem eine von mir geprüfte Demo-Antwort: „Wir starten nicht mit deinem ganzen Betrieb, sondern mit einem eng begrenzten Ablauf. Erst wenn der stabil läuft, kommt der nächste dazu.“
Aus den fünf Calls wird ein Graph mit elf Knoten: fünf Calls, ein Muster mit der Eigenschaft „Häufigkeit 3 von 5, geprüft 21.09.2026“, eine Antwort mit „Version 2, freigegeben“, eine Zielgruppe „Handwerksbetrieb, zehn bis zwanzig Leute“ und drei Verwendungen: FAQ-Antwort, Einwandkarte, Content-Idee. Dazu acht Beziehungen: Demo-Call 01, 03 und 05 enthalten den Einwand, jede Kante mit der Minute im Gespräch. Der Einwand betrifft die Zielgruppe Handwerksbetrieb. Die geprüfte Demo-Antwort beantwortet den Einwand, an der Kante steht das Signal: keine Rückfrage in zwei der drei Calls. FAQ-Antwort, Einwandkarte und Content-Idee nutzen die Antwort. Jede Kante führt zurück zu einer Fundstelle oder zu einer menschlichen Freigabe. Der Graph bildet keine neue Wahrheit, er verbindet belegte Elemente.
Jetzt die Abfragen, für die du das Ganze gebaut hast. In Cypher, der Abfragesprache von Neo4j, stehen Knoten in runden und Beziehungen in eckigen Klammern. Die Frage „Welche Verwendungen hängen an einer Antwort, die seit mehr als sechs Monaten nicht geprüft wurde?“ sieht als Muster so aus:
MATCH (v:Verwendung)-[:NUTZT]->(a:Antwort)
WHERE a.geprueft < date() - duration('P6M')
RETURN v.kanal, a.text, a.geprueft
Drei Fragen, die das Demo-Modell in einem Zug beantwortet:
Welche Antworten sind in mehreren Kanälen aktiv? Antwort-Knoten mit mehr als einer eingehenden „nutzt“-Beziehung. Im Demo-Graph: eine, mit drei Verwendungen.
Welche häufigen Einwände haben noch keine freigegebene Antwort? Muster über deiner Häufigkeitsschwelle ohne eingehende „beantwortet“-Beziehung. In einem echten Register sind das die Einträge mit Status „offen“.
Was muss ich anfassen, wenn ich die Antwort ändere? Von der Antwort entlang „nutzt“ rückwärts zu allen Verwendungen. In einer Tabelle sind das Filter mit Verweisnummern und Zwischenlisten, im Graph ein Pfad.
Knowledge Graph aus Text erstellen: was das Modell vorschlägt und was du prüfst
Die Knoten und Kanten tippt niemand von Hand ein. Ein Sprachmodell kann aus dem pseudonymisierten Registereintrag Vorschläge machen: Das ist ein Muster, das ist die Antwort dazu, dieser Call ist die Fundstelle. So entsteht ein Knowledge Graph aus Text. Drei Regeln halten das sauber:
Das Modell schlägt Kanten vor, du bestätigst sie. Eine vorgeschlagene Beziehung „beantwortet“ ist eine Hypothese, bis jemand die Fundstelle gelesen hat. Unsichere Vorschläge bleiben markiert.
Nur aus geprüften Einträgen. Der Graph wird aus dem Register gebaut, nicht aus dem Rohtranskript. Was im Register nicht steht, steht auch im Graph nicht.
Stichprobe nach jedem Lauf. Modelle glätten Sprache und verbinden gern, was nur ähnlich klingt. Zehn zufällige Kanten gegen die Fundstellen lesen, bevor der Lauf übernommen wird.
Register, Wissensdatenbank oder Graph?
Du brauchst nicht automatisch eine Graphdatenbank.
Register: richtig, wenn wenige Personen eine überschaubare Liste pflegen und nach Kategorie filtern.
Wissensdatenbank: richtig, wenn Mitarbeitende Fragen stellen und eine Antwort mit Quelle erhalten sollen. Der Aufbau steht in KI-Wissensdatenbank aus Calls.
Knowledge Graph: richtig, wenn Beziehungen selbst wichtig werden, zum Beispiel Quellen, Zielgruppen, Abhängigkeiten und Wiederverwendung.
Oft reicht für den Anfang ein sauberes Datenmodell in einer Tabelle mit einem zweiten Blatt für die Beziehungen; ein Graphwerkzeug lohnt sich, wenn die Abfragen echten Nutzen bringen.
Fünf Regeln für einen belastbaren Graphen
Nur geprüfte Einträge übernehmen. Ein Modellfehler wird durch eine Linie nicht wahrer.
Beziehungen eindeutig benennen. „gehört zu“ ist meistens zu unscharf, und ohne Richtung und Datum weißt du später nicht, was von was abhängt.
Quelle und Freigabe mitführen. Jede fachliche Antwort braucht Herkunft, Verantwortlichen und Prüftermin.
Personenbezug begrenzen. Pseudonymisierte Gesprächsdaten bleiben personenbezogen, solange eine Zuordnung möglich ist.
Mit echten Fragen testen. Wenn der Graph keine Entscheidung verbessert, ist er Dekoration.
Für Gesprächsdaten gilt weiterhin: Einwilligung und Rechtsgrundlage werden vor der Aufnahme geklärt. Lokale Transkription reduziert Datenwege, ersetzt aber keine Rechtsgrundlage. Der Überblick steht in Gespräche transkribieren: was rechtlich gilt.
Wie Gustav in diesen Ablauf passt
Gustav ist bei mir der KI-Mitarbeiter vor dem Graphen. Er transkribiert mit Whisper lokal, führt den festen Pseudonymisierungs-Pass durch und baut in Etappen von zehn bis zwanzig Calls das Muster-Register, nach jeder Etappe mit Stichproben-Review. Dazu führt er eine Kartei, über die jederzeit auffindbar ist, welcher Call zu welcher Person gehört, damit eine Löschanfrage umsetzbar bleibt. Für den Graph heißt das: Jeder Call-Knoten hat einen Weg zurück in die Kartei, und wenn ein Call gelöscht wird, siehst du entlang der Kanten, welche Muster und Antworten davon betroffen sind. Der Knowledge Graph ist eine Ansicht dieses Registers. In welchem Werkzeug sie liegt, entscheidest du: Tabelle, Notizsystem oder Graphdatenbank, das Modell bleibt dasselbe.
Was ist der Unterschied zwischen Knowledge Graph und Wissensdatenbank?
Eine Wissensdatenbank beantwortet Fragen mit Quelle, ein Knowledge Graph zeigt, was womit zusammenhängt. In der Wissensdatenbank suchst du „keine Zeit für die Einrichtung“ und bekommst die geprüfte Antwort samt Fundstelle. Im Graph fragst du, in welchen Calls der Einwand fiel und welche FAQ-Absätze an der Antwort hängen. Beides kann aus demselben Register entstehen.
Was ist ein Knowledge Graph, einfach erklärt?
Ein Netz aus Dingen und benannten Verbindungen. Die Dinge heißen Knoten, die Verbindungen Beziehungen, und beide können Eigenschaften tragen wie Datum oder Häufigkeit. Der Unterschied zur Tabelle: Die Verbindung ist selbst ein Datensatz mit Richtung und Typ, nicht eine Verweisnummer in einer Spalte.
Kann KI einen Knowledge Graph aus Text erstellen?
Vorschlagen ja, entscheiden nein. Ein Sprachmodell kann aus einem pseudonymisierten Registereintrag Knoten und Kanten vorschlagen. Ob die Kante stimmt, prüft ein Mensch an der Fundstelle, denn Modelle verbinden gern, was nur ähnlich klingt. Die Eingabe ist das geprüfte Register, nicht das Rohtranskript.
Welche Software brauche ich, um einen Knowledge Graph zu erstellen?
Für das Modell keine, für den Betrieb eine, die zu deinen Abfragen passt. Knotentypen, Beziehungstypen und Eigenschaften entstehen auf Papier oder in einer Tabelle mit einem zweiten Blatt für die Beziehungen. Erst wenn Fragen wie „Was hängt an dieser Antwort?“ regelmäßig kommen, lohnt sich eine Graphdatenbank, Neo4j mit der Abfragesprache Cypher ist ein Beispiel.
Ist ein Knowledge Graph aus Gesprächen anonym?
Nein, solange eine Zuordnung besteht. Rolle, Branche, Datum und ein wörtliches Zitat können zusammen eine Person wieder erkennbar machen, und die Kartei, die Calls Personen zuordnet, hält den Personenbezug ohnehin aufrecht. Der Graph braucht deshalb Zweck, Zugriffsschutz und Löschfrist wie das Register. Von anonym sprichst du erst nach gelöschter Zuordnung und bestandener Reidentifikations-Prüfung.
Wie du weitermachst
Nimm drei Fragen, die dir dein Register heute nicht in einem Zug beantwortet, und schreib sie auf. Markiere die Substantive und die Verben. Dann nimm fünf Einträge aus deinem Register und leg sie als Knoten und Kanten auf ein Blatt. Beantwortet das Blatt die drei Fragen, hast du dein Modell; wenn nicht, fehlt ein Knotentyp oder eine Beziehung.
Das Register davor führt bei mir Gustav, mit Pseudonymisierungs-Pass, Etappen-Review und Kartei. Sein Paket liegt in meiner Community, und den ersten Graph baust du dort nicht allein: In den Calls gehen wir Modelle gemeinsam durch, und eine Frage in einem Posting findet meist jemanden, der dieselben drei Fragen schon gestellt hat. Alles dazu unter Community.
Kevin Welter
Entwickler, IT-Architekt, Fachbuchautor (Kubernetes, Cloud-Infrastrukturen) und Speaker. Betreibt sein Business mit einer KI-Belegschaft aus vierzehn KI-Mitarbeitern und zeigt Selbstständigen in seiner Community, wie sie ihren ersten KI-Mitarbeiter einstellen.