Context Engineering: Kontext schlägt Prompt
Context Engineering erklärt: was es meint, wie es sich von Prompt Engineering unterscheidet, welche Bausteine zählen und welche Fehler du vermeidest.
Zum Artikel17. September 2026 · Aktualisiert am 21. September 2026 · 14 Min. Lesezeit
Mehrere KI-Agenten zu orchestrieren heißt nicht, zwei Fenster gleichzeitig offen zu haben. Orchestrierung fängt an dem Punkt an, an dem drei Dinge geregelt sind: Jeder Agent hat eine Zuständigkeit, die sich am Ergebnis festmacht und nicht am Werkzeug, jede Übergabe ist geschrieben, und eine Stelle prüft, ob der Bericht dem entspricht, was tatsächlich passiert ist. Nach meiner Erfahrung ist der Sprung von einem auf zwei Agenten der größere, nicht der von zwei auf fünf, weil er genau diese drei Regeln erzwingt. Der technische Grund ist simpel: Ein Subagent läuft laut Anthropic-Dokumentation in einem eigenen Kontextfenster und sieht deinen Gesprächsverlauf nicht. Was Agent eins im Kopf hatte, muss für Agent zwei aufgeschrieben sein, sonst existiert es nicht. Gescheitert ist es fast immer an denselben vier Stellen: unscharfe Aufträge, doppelte Arbeit, zu viel Parallelität an derselben Datei und ungeprüfte Berichte.
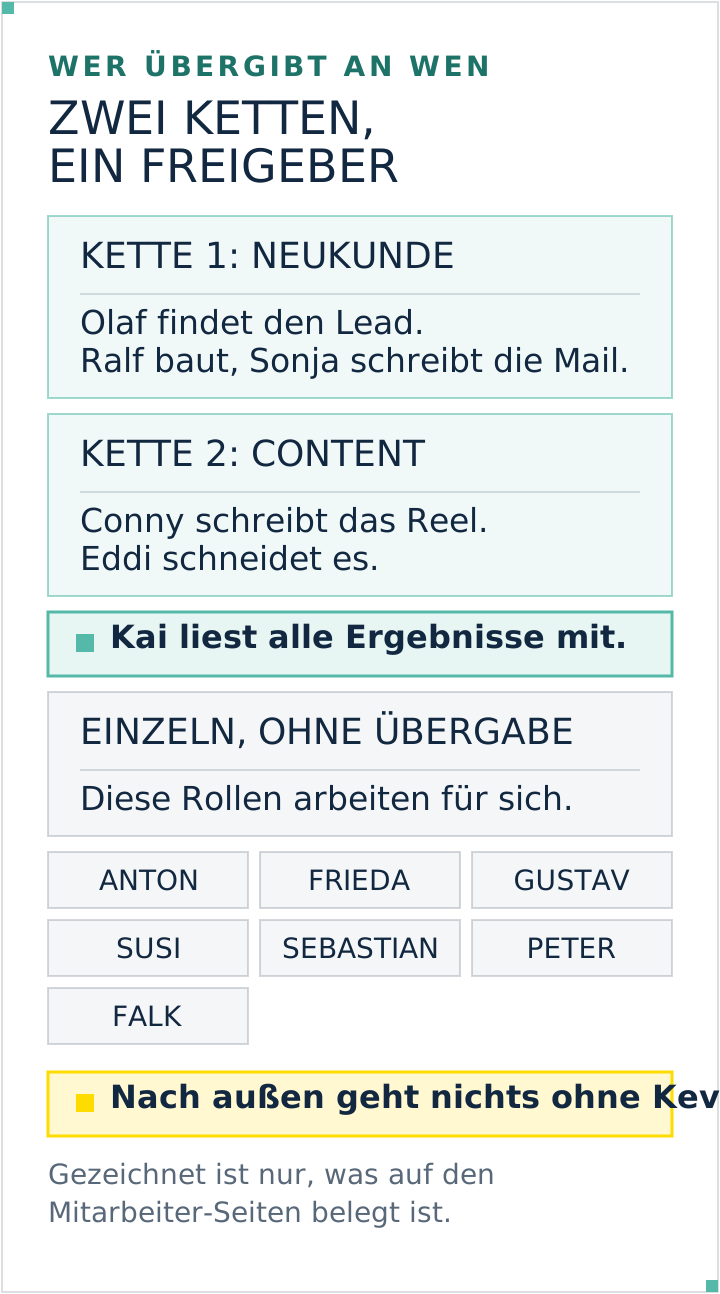
Ich führe mein Geschäft mit einer Belegschaft aus fünfzehn KI-Mitarbeitern, jeder mit eigener Rolle, eigener Personalakte und eigenen Grenzen. Wer bei mir welchen Job macht, steht im Organigramm. Sie rufen einander auf: Meine SEO-Rolle fragt bei der Content-Redaktion nach Erfahrungswerten, die Redaktion gibt einen Videoauftrag an den Editor weiter, und eine Führungsrolle sichtet hinterher das Ergebnis. Auch dieser Beitrag ist so entstanden: Suchbegriff-Analyse und Entwurf aus meiner SEO-Rolle, der Einbau auf die Website aus einer zweiten, freigegeben habe ich. Wie die Belegschaft gewachsen ist, steht in KI-Belegschaft: 15 Mitarbeiter, ein Chef, alle Agenten-Themen sammle ich auf der Seite KI-Agenten.
Mit einem Agenten bist du der Kontext: Du siehst jeden Zwischenschritt, und wenn etwas schiefgeht, korrigierst du im selben Gespräch. Mit zwei Agenten fällt dieser geteilte Kontext schlagartig weg.
| Ein Agent | Zwei oder mehr Agenten | |
|---|---|---|
| Kontext | geteilt, du bist mittendrin | getrennt, jeder sieht nur seinen Auftrag |
| Auftrag | „mach weiter wie besprochen" reicht | Ziel, Format, Quellen und Grenzen müssen im Auftrag stehen |
| Übergabe | passiert im Gespräch | muss als Datei existieren, sonst geht sie verloren |
| Rechte | du siehst jeden Werkzeugaufruf | je Rolle festzulegen, wer lesen und wer ändern darf |
| Überblick | du liest jedes Ergebnis selbst | eine Stelle verdichtet, du entscheidest |
Die Anthropic-Dokumentation zu Subagents beschreibt den Kontextschnitt genau: Ein Subagent bekommt seinen eigenen System-Prompt, den Auftragstext, die CLAUDE.md-Hierarchie des Projekts und die Skills, die du ihm vorlädst. Was er nicht bekommt: deinen Gesprächsverlauf, die Dateien, die dein Hauptgespräch schon gelesen hat, und die Skills, die dort schon liefen. Das ist kein Mangel, sondern der Zweck: Genau deshalb bleibt dein Hauptgespräch schlank.
Der unangenehmste Punkt kommt zum Schluss: Ab dem zweiten Agenten liest du nach meiner Erfahrung nicht mehr alles. Das ist der eigentliche Grund für Orchestrierung.
Die haltbare Trennlinie verläuft am Ergebnis: Wer liefert was ab, wer ist danach fertig. „Der eine recherchiert, der andere schreibt" ist eine gute Trennung, weil die Übergabe ein fertiges Dokument ist. „Der eine nutzt die Websuche, der andere das Dateisystem" ist eine schlechte, weil beide dieselbe Aufgabe an verschiedenen Enden anfassen und keiner sie abschließt.
Anthropic beschreibt in seinem Bericht zum eigenen Multi-Agenten-Recherchesystem, was passiert, wenn die Grenze fehlt: In einem Lauf untersuchte ein Subagent die Chipkrise 2021, während zwei weitere parallel an aktuellen Lieferketten arbeiteten. Doppelte Arbeit, dreimal bezahlt. Ihre Konsequenz: Jeder Subagent braucht ein Ziel, ein Ausgabeformat, eine Angabe zu Werkzeugen und Quellen und klare Aufgabengrenzen.
Bei mir läuft jede Übergabe über dasselbe, bewusst langweilige Protokoll. Der Absender legt eine Übergabedatei in seinen eigenen Ausgang und eine Kopie in den Eingang des Empfängers. Darin stehen Absender, Empfänger, Datum, das Anliegen, ein Link auf den Kontext und die offenen Punkte samt Risiken. Jeder Mitarbeiter sieht am Sitzungsstart in seinen Eingang und schiebt gelesene Briefe in einen Erledigt-Ordner.
Zwei Details machen den Unterschied. Erstens der Link statt der Kopie: So gibt es eine Quelle statt mehrerer Abschriften. Kopien veralten still, ein Pfad wird höchstens einmal umbenannt. Zweitens der Ausgang beim Absender: Damit ist auch Wochen später belegbar, wer wann was übergeben hat. Ein Agent hat kein Gedächtnis über Sitzungen hinweg, dein Dateisystem schon. Wie dieser dauerhafte Rollen-Kontext aussieht, steht in CLAUDE.md: das Gedächtnis von Claude Code.
Bei drei Berichten am Tag liest du drei Berichte. Bei zehn überfliegst du sie. Ab da brauchst du eine Stelle, die vor dir liest und verdichtet: Was ist fertig, was hängt, worüber musst du entscheiden.
Wichtig ist, was diese Stelle tut. Ein Dashboard zeigt Zahlen. Eine Überblicksrolle vergleicht die Behauptung mit dem Beleg: Der Bericht sagt, sechs Seiten seien live, also werden die sechs Adressen abgerufen. Findet sie keinen Beleg, schreibt sie „nicht belegt" hin, statt die Lücke zu glätten.
Wie du daraus einen belegbaren Projektstand mit Aufgaben und Prüfungen machst, beschreibt KI im Projektmanagement mit KI-Mitarbeitern.
Alles, was bei mir das Haus verlässt, prüft eine getrennte Rolle in frischem Kontext, nicht derselbe Lauf, der es erstellt hat. Der Grund ist belegt: Selbstkorrektur ohne fremde Prüfung verschlechtert Ergebnisse, externe Prüfung verbessert sie (Huang et al., ICLR 2024). Die Kehrseite gehört dazu: Ein Prüfer, den du zum Lückenfinden aufforderst, findet immer Lücken. Deshalb steht in meinen Prüfaufträgen „nur melden, was die Richtigkeit betrifft". Die Praxisregeln für solche Prüfrollen stehen in Claude Code Subagents: Best Practices, die Begriffsunterschiede zwischen Subagent, Skill und Agent in Claude Subagents, Skills und Agents.
Merkst du an Schritt 1, dass Agent eins gar kein sauberes Ergebnis abliefert, sondern ein Gespräch ist, dann fehlt nicht der zweite Agent, sondern die Einarbeitung des ersten. Wie die abläuft, steht in KI-Mitarbeiter einstellen: der Ablauf, und welche Aufgaben sich eignen, in Welche Aufgaben du an KI abgeben kannst.
Diese Frage wird beim ersten Agenten gern übersprungen und rächt sich beim dritten. Drei Ebenen reichen.
Werkzeugrechte je Rolle. Die Doku kennt dafür zwei Felder: tools als Positivliste, disallowedTools als Sperrliste, wobei die Sperrliste zuerst greift. Ein Prüfer bekommt Lese-Werkzeuge und kein Write. Ein Detail, das leicht danebengeht: Die Werkzeugliste eines Subagents und die feineren Berechtigungsregeln sind zwei verschiedene Ebenen. Ein Eintrag wie disallowedTools: Bash(git push *) entfernt laut Doku das gesamte Bash-Werkzeug, nicht nur den einen Befehl. Wer Bash behalten und allein diesen Befehl sperren will, hinterlegt ihn als Verbotsregel in den Berechtigungen.
Zugriff auf fremde Arbeitsergebnisse. Meine Regel: Jeder darf alles lesen, niemand ändert die Ergebnisse eines anderen. Wer etwas zu beanstanden hat, schreibt einen Brief in dessen Feedback-Ordner. Das klingt umständlich und spart viel Ärger, weil nie zwei Instanzen an derselben Datei stehen.
Das Freigabe-Gate. Was nach außen geht oder Zustand ändert, gebe ich frei, mit Wortlaut und Zeitpunkt im Protokoll. Kein Agent verschickt eine Mail, kein Agent stellt etwas online, kein Agent gibt Geld aus. Wo die Grenze zwischen Sichten und Entscheiden im Einzelnen verläuft, steht in Was darf eine KI-Führungsrolle entscheiden?. Wie so ein Gate in Claude Code und n8n technisch aussieht, zeigt Human in the Loop: Bedeutung und Beispiele.
| Fehler | Woran du ihn merkst | Gegenmittel |
|---|---|---|
| Unscharfe Aufgabengrenze | Zwei Agenten liefern dasselbe in anderen Worten | Ziel, Format, Quellen, Grenzen in jeden Auftrag |
| Kontext im Kopf statt in der Datei | Agent zwei fragt nach Dingen, die Agent eins längst wusste | Übergabe als Datei, Link auf den Kontext |
| Zu viel Parallelität | Widersprüchliche Stände derselben Datei | Nacheinander, bis die Übergabe sitzt |
| Kein Prüfschritt | Berichte klingen gut, der echte Stand weicht ab | Getrennte Prüfrolle, Behauptung gegen Beleg |
| Alles selbst lesen wollen | Du bist der Engpass, die Agenten warten | Eine Stelle, die verdichtet |
| Falscher Anlass | Aufgabe braucht durchgehend denselben Kontext | Bei einem Agenten bleiben |
Der letzte Punkt ist der teuerste. Ein Multi-Agent-System, also mehrere Agenten, die an einer Aufgabe zusammenarbeiten, kostet zuerst einmal mehr: Anthropic nennt zum eigenen Mehr-Agenten-System zwei Zahlen, die zusammengehören: Agenten verbrauchen typischerweise etwa das Vierfache an Tokens eines Chats, Mehr-Agenten-Systeme etwa das Fünfzehnfache. Und Aufgaben, bei denen alle Beteiligten denselben Kontext teilen müssen oder viele Abhängigkeiten untereinander haben, eignen sich dafür heute nicht gut. Zwei Agenten sind also kein Fortschritt an sich, sie lohnen sich bei wirklich unabhängigen Teilaufgaben. Fünf Blogbeiträge zu fünf Themen: ja. Fünf Änderungen an derselben Datei: nein.
Bei mir heißt die Stelle, die den Überblick behält, Kai. Er hat keine eigene Oberfläche, er liest das, was die anderen ohnehin hinterlassen: die Git-Historie jedes Mitarbeiters, die Berichte und Protokolle im gemeinsamen Ordner und das Postfach. Nach einer Sitzung hält er jede Behauptung gegen den Stand im Dateisystem und auf der Live-Website und schreibt daraus einen kurzen Bericht mit dem, worüber ich entscheiden muss.
Wie das konkret aussieht, zeigt seine Sichtung vom 05.09.2026. Er prüfte die Arbeit von zwei Mitarbeitern und fand drei Dinge: einen unvollständigen Korrekturlauf an einer Kundenwebsite, bei dem die Blogartikel repariert, die dahinterliegenden Seiten aber unverändert geblieben waren, sodass sich die Seite an fünf Stellen selbst widersprach; einen Mitarbeiter, der dauerhaft auf einer Berechtigungsstufe ohne Rückfragen stand; und eine Wissensdatei, die ein Skript geändert hatte, ohne dass ein Protokoll zeigte, wer dahinterstand. Umgekehrt bestätigte dieselbe Sichtung einen abgeschlossenen Rollout: sechs Kernrouten live geprüft, der veraltete Satz danach mit null Treffern, der neue zweimal vorhanden.
Das ist der Unterschied zwischen mehreren unabhängig laufenden Agenten und echter Orchestrierung. Kai meldet in beide Richtungen, was stimmt und was fehlt. Entscheiden tut er nichts: keine fachliche Entscheidung, keine Freigabe, kein Commit. Genau deshalb funktioniert die Rolle. Die ausführliche Fassung steht auf Kai, der den Überblick behält.
Kai ist kein Einsteiger-Mitarbeiter, er setzt mehrere laufende Agenten voraus. Wer dort hinwill, baut ihn sich selbst, und allein muss das niemand tun: Den Weg dahin gehen wir in meiner Community und in den Calls gemeinsam durch. Was einen Agenten überhaupt ausmacht, erkläre ich in Was ist ein KI-Agent? Einfach erklärt. Der praktische Einstieg ist Claude lernen: der Weg in fünf Stufen, und welche Aufgaben sich als erste Agenten eignen, zeigen die zehn Fälle in KI-Agenten: 10 Beispiele aus der Praxis.
Eine feste Zahl gibt es nicht. Die brauchbare Faustregel ist kein Zählwert, sondern ein Verhalten: Sobald du anfängst, Berichte zu überfliegen statt zu lesen, brauchst du eine Stelle, die vor dir liest. Bei mir kam diese Rolle nicht am ersten Tag, sondern als die Belegschaft schon lief.
Von sich aus nicht. Laut Anthropic-Doku läuft ein Subagent in einem eigenen Kontextfenster und sieht den Gesprächsverlauf der Hauptsitzung nicht. Er sieht seinen Auftragstext, seinen System-Prompt und die Projektdateien, die er lesen darf. Deshalb muss jede Übergabe als Datei existieren.
Der Form nach ja: mehrere agentisch arbeitende Rollen, jede mit eigenem Kontext, verbunden über geschriebene Übergaben und eine Prüfstelle. Was „agentisch" dabei genau heißt und wo die Grenze zu generativer KI liegt, steht in Agentische KI: was das ist und was nicht. Der Unterschied zu einem System, das von selbst durchläuft, ist die Freigabe: Nach außen geht nichts ohne mein Wort, und die Überblicksrolle entscheidet nichts Fachliches.
Ein Dashboard zeigt, dass ein Lauf fertig ist. Es prüft nicht, ob das Ergebnis stimmt. Der entscheidende Handgriff ist der Abgleich von Behauptung und Beleg: Bericht sagt live, also Adresse abrufen. Bericht sagt ersetzt, also im Projekt nach dem alten Text suchen. Das leistet kein Statusanzeiger, sondern eine Rolle mit Prüfauftrag; ob dein Betrieb schon eine KI-Führungsrolle braucht, klärt der eigene Beitrag.
Indem jeder Auftrag ein Ziel, ein Ausgabeformat, erlaubte Quellen und ausdrückliche Grenzen nennt. Anthropic hat in eigenen Läufen beobachtet, dass Subagenten ohne diese Angaben redundant arbeiten, bis hin zu drei Agenten am selben Thema. Die Grenze gehört in den Auftrag, nicht in die Hoffnung.
Der aktuelle Standard liegt laut Claude-Code-Doku, abgerufen am 20.09.2026, bei 20 gleichzeitigen Subagenten und drei Verschachtelungsebenen, beides über Umgebungsvariablen einstellbar. Das sind Werte einer Produktversion und keine feste Grenze, frühere Versionen hatten andere. Praktisch ist die Zahl ohnehin ein Limit und keine Empfehlung: Jede Instanz liest ihren Kontext neu ein, und parallele Läufe an derselben Datei erzeugen widersprüchliche Stände.
Bei mir: nichts Fachliches. Sie sichtet, verdichtet, stellt Rückfragen und markiert Lücken, gibt aber nichts frei, ändert keine Ergebnisse anderer und schreibt nichts fest. Fachliche Aufträge erteilt sie nur auf meine ausdrückliche Anweisung. Die Trennung zwischen Sichten und Entscheiden ist der Grund, warum ich ihr die Sichtung überhaupt überlasse.
Schreib zwei Sätze auf: Was liefert dein laufender Agent ab, und welche Aufgabe fängt an, sobald er fertig ist. Der zweite Satz beschreibt deinen zweiten Agenten. Leg dafür den Auftragsbrief an, richte die drei Postfach-Ordner ein und lass beide nacheinander laufen. Ist diese Übergabe zweimal sauber durchgelaufen, hast du orchestriert, alles Weitere ist dieselbe Mechanik in größerer Zahl.
Den Weg dorthin, von der ersten Sitzung bis zur eigenen Belegschaft, gehen wir Schritt für Schritt in meiner Community durch, mit den fertigen Rollen-Paketen als Startpunkt.
Context Engineering erklärt: was es meint, wie es sich von Prompt Engineering unterscheidet, welche Bausteine zählen und welche Fehler du vermeidest.
Zum Artikel10 KI-Agenten-Beispiele für Unternehmen und Privatpersonen: was der Agent jeweils tut, welches Werkzeug-Muster dahintersteckt, womit du startest.
Zum Artikel
Kevin Welter
Entwickler, IT-Architekt, Fachbuchautor (Kubernetes, Cloud-Infrastrukturen) und Speaker. Betreibt sein Business mit einer KI-Belegschaft aus fünfzehn KI-Mitarbeitern und zeigt Selbstständigen in seiner Community, wie sie ihren ersten KI-Mitarbeiter einstellen.
In einer Stunde läuft dein erster KI-Mitarbeiter
7 Tage kostenlos testen